Brett L.Schuchert
本附录扩充了“并发编程”一章的内容,由一组相互独立的主题组成,你可以按随意顺序阅读。为了实现这样的阅读方式,节与节之间存在一些重复内容。
A.1 客户端/服务器的例子
想像一个简单的客户端/服务器应用程序。服务器在一个套接字上等待接受来自客户端的连接请求。客户端连接到服务器并发送请求。
A.1.1 服务器
下面是服务器应用程序的简化版本代码。在后文“客户端/服务器非多线程版本”一节中有完整的代码。
ServerSocket serverSocket = new ServerSocket(8009);
while (keepProcessing) {
    try {
        Socket socket = serverSocket.accept();
        process(socket);
    } catch (Exception e) {
        handle(e);
    }
}
这个简单的应用等待连接请求,处理接收到的新消息,再等待下一个客户端请求。下面是连接到服务器的客户端代码:
private void connectSendReceive(int i) {
    try {
        Socket socket = new Socket("localhost", PORT);
        MessageUtils.sendMessage(socket, Integer.toString(i));
        MessageUtils.getMessage(socket);
        socket.close();
    } catch (Exception e) {
        e.printStackTrace();
    }
}
这对客户端/服务器程序运行得如何呢?怎样才能正式地描述其性能?下面是断言其性能“可接受”的测试:
@Test(timeout = 10000)
public void shouldRunInUnder10Seconds() throws Exception {
    Thread[] threads = createThreads();
    startAllThreadsw(threads);
    waitForAllThreadsToFinish(threads);
}
为了让例子够简单,设置过程被忽略了(见后文ClientText.java部分)。测试断言程序应该在10000毫秒内完成。
这是个验证系统吞吐量的典型例子。系统应该在10秒钟以内完成一组客户端请求。只要服务器能在时限内处理每个客户端请求,测试就通过了。
如果测试失败会怎样?缺少了某些事件轮询机制,在单个线程上也没什么可让代码更快的手段。使用多线程能解决问题吗?可能会,我们先得了解什么地方耗费时间。下面是两种可能:
I/O——使用套接字、连接到数据库、等待虚拟内存交换等;
处理器——数值计算、正则表达式处理、垃圾回收等。
以上在系统中都会部分存在,但对于特定的操作,其中之一会起主导作用。如果代码运行速度主要与处理器有关,增加处理器硬件就能提升吞吐量,从而通过测试。但CPU运算周期是有上限的,因此,只是增加线程的话并不会提升受处理器限制的代码的速度。
另一方面,如果吞吐量与I/O有关,则并发编程能提升运行效率。当系统的某个部分在等待I/O,另一部分就可以利用等待的时间处理其他事务,从而更有效地利用了CPU能力。
A.1.2 添加线程代码
假定性能测试失败了。如何才能提高吞吐量、通过性能测试呢?如果服务器的process方法与I/O有关,就有个办法让服务器利用线程(只需要修改processMessage):
void process(final Socket socket) {
    if (socket == null)
        return;
    Runnable clientHandler = new Runnable() {
        public void run() {
            try {
                String message = MessageUtils.getMessage(socket);
                MessageUtils.sendMessage(socket, "Processed: " + message);
                closeIgnoringException(socket);
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
    };
    Thread clientConnection = new Thread(clientHandler);
    clientConnection.start();
}
假设修改后测试通过了1。代码是否完整、正确了呢?
A.1.3 观察服务器端
修改了的服务器成功通过测试,只花费了一秒多钟时间。不幸的是,这种解决手段有点一厢情愿,而且导致了新问题产生。
服务器应该创建多少个线程?代码没有设置上限,所以我们很有可能达到 Java 虚拟机(JVM)的限制。对于许多简单系统来说这无所谓。但如果系统要支持公众网络上的众多用户呢?如果有太多用户同时连接,系统就有可能挂掉。
不过先把性能问题放到一边吧。这种手段还有整洁性和结构上的问题。服务器代码有多少种权责呢?
套接字连接管理;
客户端处理;
线程策略;
服务器关闭策略。
这些权责不幸全在process函数中。而且,代码跨越多个抽象层级。所以,即便 process函数这么短小,还是需要再加以切分。
服务器有几个修改的原因,所以它违反了单一权责原则。要保持并发系统整洁,应该将线程管理代码约束于少数几处控制良好的地方。而且,管理线程的代码只应该做管理线程的事。为什么?即便无需同时考虑其他非多线程代码,跟踪并发问题都已经足够困难了。
如果为上述每个权责(包括线程管理权责在内)创建单独的类,当改动线程管理策略时,就会对整个代码产生较小影响,不至于污染其他权责。这样一来,也能在不担心线程问题的前提下测试所有其他权责。下面是修改过的版本:
public void run() {
    while (keepProcessing) {
        try {
            ClientConnection clientConnection = connectionManager.awaitClient();
ClientRequestProcessor requestProcessor
            = new ClientRequestProcessor(clientConnection);
            clientScheduler.schedule(requestProcessor);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
    connectionManager.shutdown();
}
所有与线程相关的东西都放到了 clientScheduler 里面。如果出现并发问题,只要看这个地方就好了:
public interface ClientScheduler {
    void schedule(ClientRequestProcessor requestProcessor);
}
并发策略易于实现:
public class ThreadPerRequestScheduler implements ClientScheduler {
    public void schedule(final ClientRequestProcessor requestProcessor) {
        Runnable runnable = new Runnable() {
            public void run() {
                requestProcessor.process();
            }
        };
        Thread thread = new Thread(runnable);
        thread.start();
    }
}
把所有线程管理隔离到一个位置,修改控制线程的方式就容易多了。例如,移植到Java 5 Executor框架就只需要编写一个新类并插进来即可(如代码清单A-1所示)。
代码清单A-1 ExecutorClientScheduler.java
import java.util.concurrent.Executor;
import java.util.concurrent.Executors;
public class ExecutorClientScheduler implements ClientScheduler {
    Executor executor;
    public ExecutorClientScheduler(int availableThreads) {
        executor = Executors.newFixedThreadPool(availableThreads);
    }
    public void schedule(final ClientRequestProcessor requestProcessor) {
        Runnable runnable = new Runnable() {
            public void run() {
                requestProcessor.process();
            }
        };
        executor.execute(runnable);
    }
}
A.1.4 小结
本例介绍的并发编程,演示了一种提高系统吞吐量的方法,以及一种通过测试框架验证吞吐量的方法。将全部并发代码放到少数类中,是应用单一权责原则的范例。对于并发编程,因其复杂性,这一点尤其重要。
A.2 执行的可能路径
复查没有循环或条件分支的单行Java方法incrementValue:
public class IdGenerator {
    int lastIdUsed;
    public int incrementValue() {
        return ++lastIdUsed;
    }
}
忽略整数溢出的情形,假定只有单个线程能访问IdGenerator的单个实体。这种情况下,只有一种执行路径和一个确定的结果:返回值等于lastIdUsed的值,两者都比调用方法前大1。
如果使用两个线程、不修改方法的话会发生什么?如果每个线程都调用一次incrementValue,可能得到什么结果呢?有多少种可能执行路径?首先来看结果(假定lastIdUsed初始值为93):
线程1得到94,线程2得到95,lastIdUsed为95;
线程1得到95,线程2得到94,lastIdUsed为95;
线程1得到94,线程2得到94,lastIdUsed为94。
最后一个结果尽管令人吃惊,也是有可能出现的。要想明白为何可能出现这些结果,就需要理解可能执行路径的数量以及Java虚拟机是如何执行这些路径的。
A.2.1 路径数量
为了算出可能执行路径的数量,我们从生成的字节码开始研究。那行 Java 代码(return++lastIdUsed;)变成了8个字节码指令。两个线程有可能交错执行这8个指令,就像庄家在洗牌时交错牌张一样2。即便每只手上只有8张牌,洗牌得到的结果数量也很可观。
对于指令系列中有N个指令和T个线程、没有循环或条件分支的简单情况,总的可能执行路径数量等于
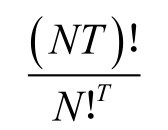
计算可能执行次序
以下摘自鲍勃大叔给Brett的一封电子邮件:
对于N步指令和T个线程,总共有T*N个步骤。在执行每步指令之前,会有在T个线程中选择其一的环境开关。因而每条路径都能以一个数字字符串的形式来表示该环境开关。对于步骤A、B及线程1和2,可能有6条可能路径:1122、1212、1221、2112、2121和2211。或者以指令步骤表示为A1B1A2B2、A1A2B1B2、A1A2B2B1、A2A1B1B2、A2A1B2B1及A2B2A1B1。对于三个线程,执行序列就是112233、112323、113223、113232、112233、121233、121323、121332、123132、123123……
这些字符串的特征之一是每个T总会出现N次。所以字符串111111是无效的,因为里面有6个1,而2和3则未出现过。
所以要排列组合N1、N2……直至NT。这其实就是N * T对应NT的排列,即(NT)!,但要剔除重复的情形。所以,巧妙之处就在于计算重复次数并从(N*T)!中剔除掉。
对于两步指令和两个线程,有多少重复呢?每个四位数字符串中都有两个1和两个2。每个这种配对都可以在不影响字符串意义的前提下调换。可以同时调换全部 1和2,也可以都不调换。所以每个字符串就有四种同构形态,即存在3次重复。所以四分之三的路径是重复的;而四分之一的排列则不重复。4!*.25=6。这样计算看来可行。
有多少重复呢?对于N=1且T=2的情形,我可以调换1,调换2,或两者都调换。对于N=2且T=3的情形,我可以调换1、2、3,1和2,1和3,或2和3。调换只是N的排列组合罢了。设有N的P种排列组合。排列组合的方式总共有P**T种。
所以可能的同构形态数量为N!**T。路径的数量就是(T*N)!/(N!**T)。对于T=2且N=2的情况,结果就是6(即24/4)。
对于N=2且T=3,结果是720/8=90。
对于N=3且T=3,结果是9!/6^3=1680。
对于一行Java代码(等同于8行字节码)和两个线程的简单情况,可能执行路径的总数量就是12870。如果lastIdUsed的类型为long,每次读/写操作都变成了两次操作,而可能的次序高达2704156种。
如果改动一下该方法会怎样?
public synchronized void incrementValue() {
    ++lastIdUsed;
}
这样一来,对于两个线程的情况,可能执行路径的数量就是2,即N!。
A.2.2 深入挖掘
两个线程都调用方法一次(在添加synchronize之前)、得到同一结果数字的惊异结果又怎样呢?怎么可能出现这种情况?一样一样来。
什么是原子操作?可以把原子操作定义为不可中断的操作。例如,在下列代码的第5行,0被赋值给lastid,就是一个原子操作。因为依据Java内存模型,32位值的赋值操作是不可中断的。
01:  public  class  Example  {
02:     int lastId;
03:
04:     public void  resetId()  {
05:       value = 0;
06:     }
07:
08:     public int  getNextId()  {
09:       ++value;
10:     }
11:  }
如果把lastId的类型从int改为long会怎样?第5行还是原子操作吗?如果不考虑JVM规约,则有可能根据处理器不同而不同。不过,根据 JVM规约,64位值的赋值需要两次32位赋值。这意味着在第一次和第二次32位赋值之间,其他线程可能插进来,修改其中一个值。
第9行的前递增操作符++又怎样呢?前递增操作符可以被中断,所以它不是原子的。为了理解这点,仔细复查一下这些方法的字节码吧。
在更进一步之前,有三个重要的定义:
框架——每个方法调用都需要一个框架。该框架包括返回地址、传入方法的参数,以及方法中定义的本地变量。这是定义一个调用堆栈的标准技术,现代编程语言用来实现基本函数/方法调用和递归调用;
本地变量——方法作用范围内定义的每个变量。所有非静态方法至少有一个变量this,代表当前对象,即接收导致方法调用的(当前线程内)大多数最新消息的对象;
运算对象栈——Java虚拟机中的许多指令都有参数。运算对象栈是放置参数的地方。堆栈是个标准的后入先出(LIFO)数据结构。
下面是restId( )的字节码,如表A-1所示。
表A-1 restId( )的字节码
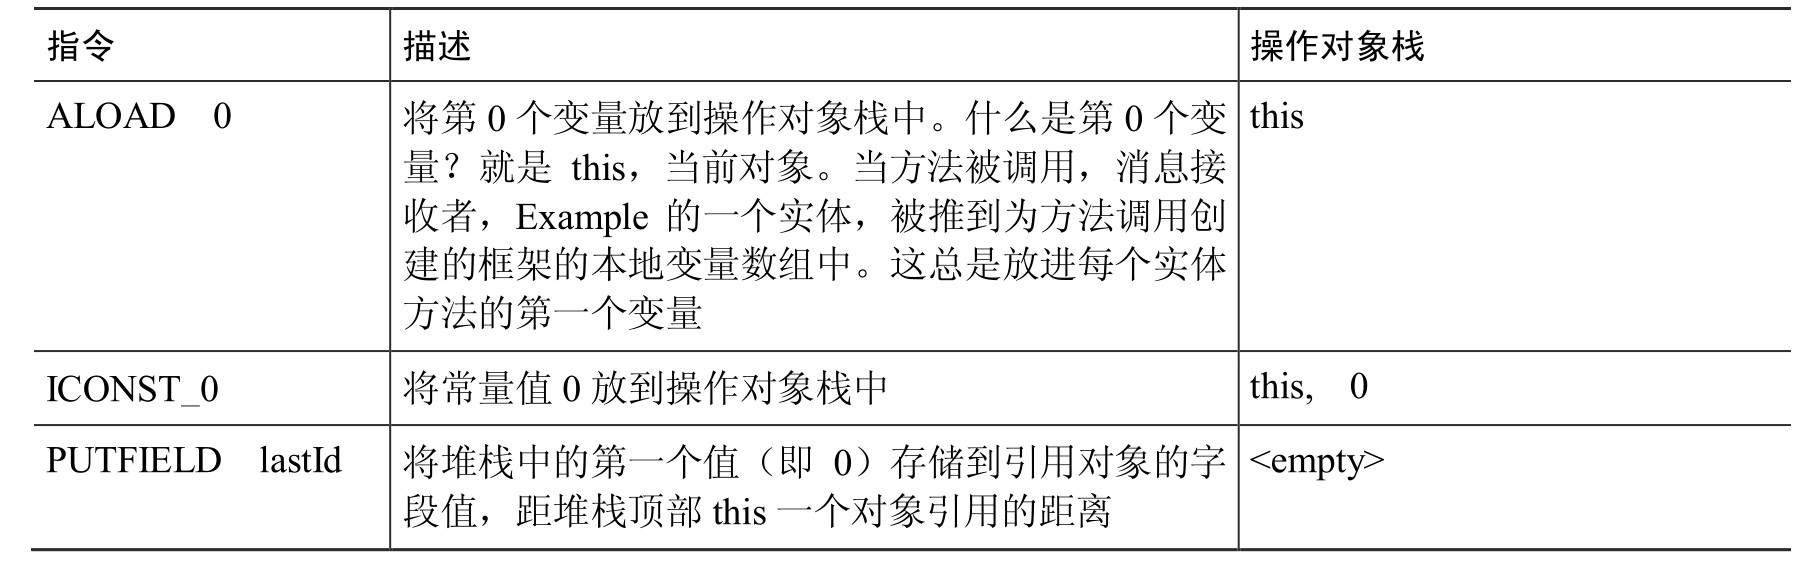
这三个指令确保是原子的,因为尽管执行它们的线程可能在其中任何一个指令后被打断,但PUTFIELD指令(堆栈顶部的常量值0和顶端之下的this引用及其字段值)的信息并不能为其他线程所触及。所以,当赋值操作发生时,值0一定将存储到字段值中。该操作是原子的。操作对象都处理对于方法而言是本地的信息,故在多个线程之间并无冲突。
所以,如果这三个指令由10个线程执行,就会有4.38679733629e+24种可能的执行次序。不过,只会有一种可能的结果,所以执行次序不同无关紧要。对于本例中的long常量,总是有同一种运算结果。为什么?因为10个线程的赋值操作都是针对一个常量的。即便它们互相干涉,结果也是一样。
方法getNextId中的++操作就会有问题了。假定lastId在方法开始时的值为42.下面是新方法的字节码,如表A-2所示。
表A-2 新方法的字节码
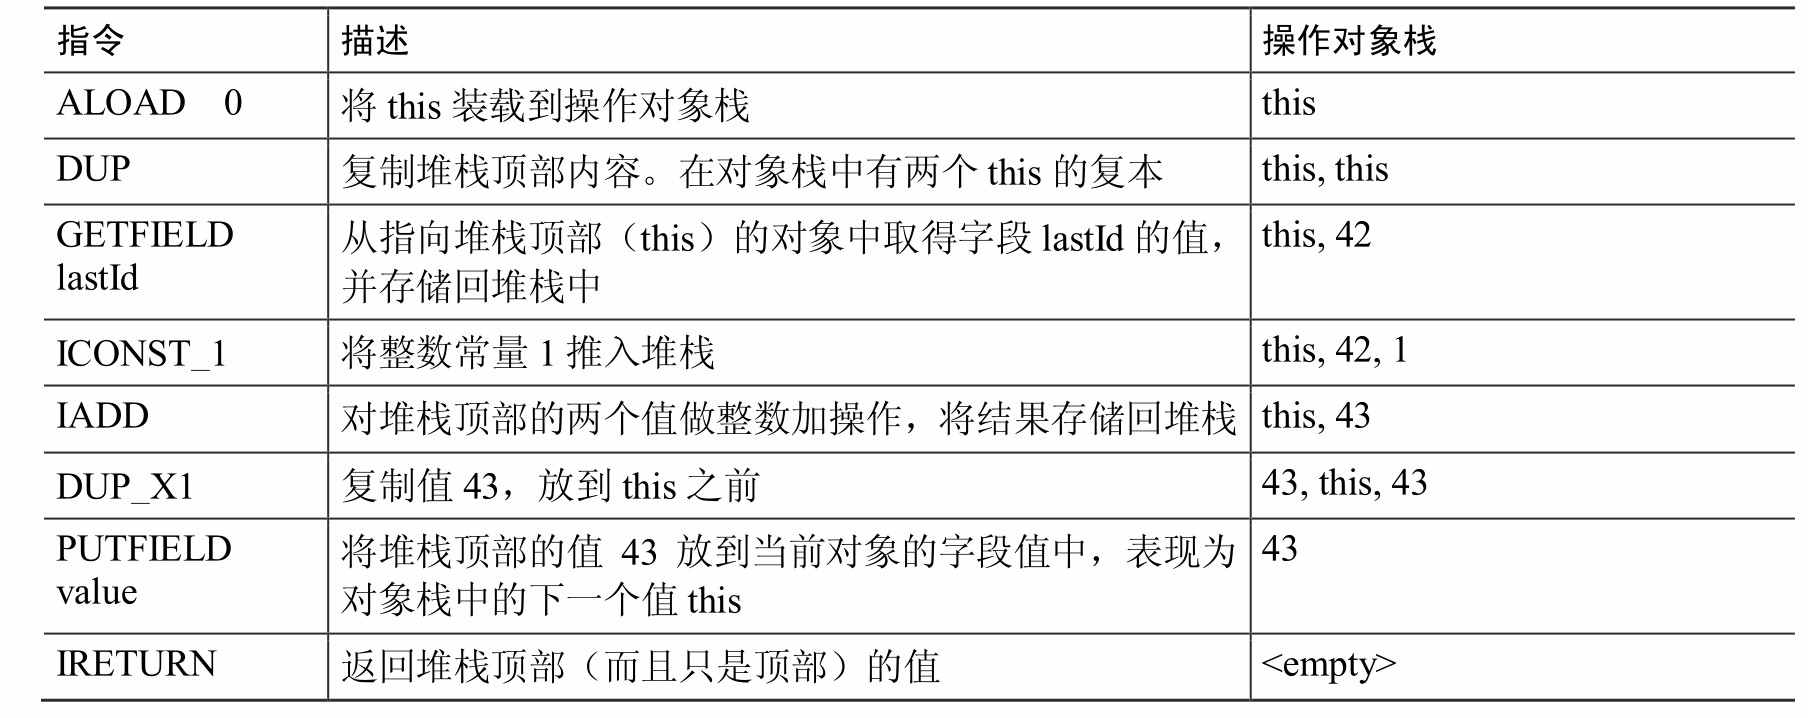
设想第一个线程完成了前三个操作,直到执行完GETFIELD,然后被打断。第二个线程接手并完成整个方法调用,lastId的值递增1;得到的值为43。第一个线程再从中断处继续执行;操作对象栈中的值还是42,因为那就是该线程执行GETFIELD时的lastId值。线程给lastId加1,得到43,存储这个结果。第一个线程也得到了值43。结果就是其中一个递增操作丢失了,因为第一个线程在被第二个线程打断后又踏入了第二个线程中。
将getNextId( )方法修改为同步方法就能修正这个问题。
A.2.3 小结
理解线程之间如何互相干涉,并不一定要精通字节码。如果你能看明白这个例子,它应该已经展示了多个线程之间互相干涉的可能性,这已经足够了。
这个小例子说明,有必要尽量理解内存模型,明白什么是安全的,什么是不安全的。有一种普遍的误解,认为++(前递增或后递增)操作符是原子的,其实并非如此。你必须知道:
什么地方有共享对象/值;
哪些代码会导致并发读/写问题;
如何防止这种并发问题发生。
A.3 了解类库
A.3.1 Executor框架
如前文ExecutorClientScheduler.java所演示的那样,Java 5中引入的Executor框架支持利用线程池进行复杂的执行。那就是java.util.concurrent包中的一个类。
如果在创建线程时没有使用线程池或自行编写线程池,可以考虑使用 Executor。它能让代码更整洁,易于理解,且更加短小。
Executor 框架将把线程放到池中,自动调整其大小,并在必要时重建线程。它还支持future,一种通用的并发编程构造。Executor 能与实现了 Runnable的类协同工作,也能与实现了Callable接口的类协同工作。Callback看来就像是Runnable,但它能返回一个结果,那在多线程解决方案中是普遍的需求。
当代码需要执行多个相互独立的操作并等待这些操作结束时,future刚好就手:
public String processRequest(String message) throws Exception {
    Callable<String> makeExternalCall = new Callable<String>() {
        public String call() throws Exception {
            String result = "";
            // make external request
            return result;
        }
    };
    Future<String> result = executorService.submit(makeExternalCall);
    String partialResult = doSomeLocalProcessing();
    return result.get() + partialResult;
}
在本例中,方法开始执行 makeExternalCall 对象。然后该方法继续其他操作。最后一行代码调用result.get( ),在future代码执行完成前,这个操作是锁定的。
A.3.2 非锁定的解决方案
Java5 虚拟机利用了现代处理器支持可靠、非锁定更新的设计优点。例如,考虑某个使用同步(从而也是锁定的)来提供线程安全地更新一个值的类:
public class ObjectWithValue {
    private int value;
    public void synchronized incrementValue() { ++value; }
    public int getValue() { return value; }
}
Java5有一系列用于此类情况的新类,例如AtomicBoolean、AtomicInteger和AtomicReference等;还有另外一些。我们可以重写上面的代码,使用非锁定的手段,如下所示:
public class ObjectWithValue {
    private AtomicInteger value = new AtomicInteger(0);
    public void incrementValue() {
        value.incrementAndGet();
    }
    public int getValue() {
        return value.get();
    }
}
即便使用了对象而非直接操作,使用了 incrementAndGet( )这样的信息发送方式而非++操作,这个类的性能还是几乎总能胜过上一版本。在某些情况下只会快一点点,但较慢的情形却几乎不存在。
怎么会这样?现代处理器拥有一种通常称为比较交换(Compare and Swap,CAS)的操作。这种操作类似于数据库中的乐观锁定,而其同步版本则类似于保守锁定。
关键字synchronized总是要求上锁,即便第二个线程并不更新同一值时也如此。尽管这种固有锁的性能一直在提升,但仍然代价昂贵。
非上锁的版本假定多个线程通常并不频繁修改同一个值,导致问题产生。它高效地侦测这种情形是否发生,并不断尝试,直至更新成功。这种侦测行为几乎总是比上锁来得划算,在争用激烈的情况下也是如此。
虚拟机如何实现这种机制?CAS的操作是原子的。逻辑上,CAS操作看起来像这样:
int variableBeingSet;
void simulateNonBlockingSet(int newValue) {
    int currentValue;
    do {
currentValue = variableBeingSet
    } while(currentValue != compareAndSwap(currentValue, newValue));
}
int synchronized compareAndSwap(int currentValue, int newValue) {
    if(variableBeingSet == currentValue) {
        variableBeingSet = newValue;
        return currentValue;
    }
    return variableBeingSet;
}
当某个方法试图更新一个共享变量,CAS操作就会验证要赋值的变量是否保有上一次的已知值。如果是,就修改变量值。如果不是,则不会碰变量,因为另一个线程正在试图更新变量值。要更新数据的方法(通过CAS操作)查看是否修改并持续尝试。
A.3.3 非线程安全类
有些类天生不是线程安全的。下面是几个例子:
数据库连接
java.util中的容器
Servlet
注意,有些群集类拥有一些线程安全的方法。不过,涉及调用多个方法的操作都不是线程安全的。例如,如果因为HashTable中已经有某物而不打算替换它,可能会写出以下代码:
if(!hashTable.containsKey(someKey)) {
                hashTable.put(someKey, new SomeValue());
}
单个方法是线程安全的。不过,另一个线程却可能在containsKey和put调用之间塞进一个值。有几种修正这个问题的手段。
先锁定HashTable,确定其他使用者都做了基于客户端的锁定:
synchronized(map) {
if(!map.conainsKey(key))
        map.put(key,value);
}
用其对象包装HashTable,并使用不同的API——利用ADAPTER模式做基于服务端的锁定:
public class WrappedHashtable<K, V> {
    private Map<K, V> map = new Hashtable<K, V>();
    public synchronized void putIfAbsent(K key, V value) {
        if (map.containsKey(key))
            map.put(key, value);
    }
}
采用线程安全的群集:
ConcurrentHashMap<Integer, String> map = new ConcurrentHashMap<Integer, String>();
map.putIfAbsent(key, value);
在java.util.concurrent中的群集都有putIfAbsent( )之类提供这种操作的方法。
A.4 方法之间的依赖可能破坏并发代码
以下是一个有关在方法间引入依赖的小例子:
public class IntegerIterator implements Iterator<Integer>
    private Integer nextValue = 0;
    public synchronized boolean hasNext() {
        return nextValue < 100000;
    }
    public synchronized Integer next() {
        if (nextValue == 100000)
            throw new IteratorPastEndException();
        return nextValue++;
    }
    public synchronized Integer getNextValue() {
        return nextValue;
    }
}
下面是使用IntegerIterator的代码:
IntegerIterator iterator = new IntegerIterator();
while(iterator.hasNext()) {
    int nextValue = iterator.next();
    // do something with nextValue
}
如果只有一个线程执行这段代码,不会有什么问题。但如果有两个线程抱着每个线程都处理它获得的值、但列表中的每个元素都只被处理一次的意图,尝试共享IntegerIterator的单个实体,会发生什么事?多数时候什么也不会发生;线程开心地共享着列表,处理从迭代器获取的元素,在迭代器完成执行时停下。然而,在迭代的末尾,两个线程也有少量可能互相干涉,导致其中一个超出迭代器末尾,抛出异常。
问题在这里。线程1调用hasNext( )方法,该方法返回true。线程1占先,然后线程2也调用这个方法,同样返回true。线程2接着调用next( ),该方法如期返回一个值,但副作用是之后再调用hasNext( )就会返回false。线程1继续执行,以为hasNext( )还是true,然后调用next( )。即便单个方法是同步的,客户端还是使用了两个方法。
这的确是个问题,也是并发代码中此类问题的典型例子。在这个特殊例子中,问题尤其隐蔽,因为只有在迭代器最后一次迭代时发生才会导致错误。如果线程刚好在那个点中断,其中一个线程就可能超出迭代器末尾。这类错误往往在系统部署之后很久才发生,而且很难追踪。
出现错误时,你有3种做法。
容忍错误;
修改客户代码解决问题:基于客户代码的锁定;
修改服务端代码解决问题,同时也修改了客户代码:基于服务端的锁定。
A.4.1 容忍错误
有时,可以通过一些设置让错误不会导致损害。例如,上述客户代码可以捕捉并清理异常。坦白地说,这有点草草从事,就像是半夜重启解决内存泄露问题一样。
A.4.2 基于客户代码的锁定
要让IntegerIterator在多线程情况下正确运行,对客户代码做如下修改:
IntegerIterator iterator = new IntegerIterator();
while (true) {
    int nextValue;
    synchronized (iterator) {
        if (!iterator.hasNext())
            break;
        nextValue = iterator.next();
    }
    doSometingWith(nextValue);
}
每个客户端都通过synchronized关键字引入一个锁。这种重复违反了DRY原则,但如果代码使用非线程安全的第三方工具,可能必须这样做。
这种策略有风险,因为使用服务端的程序员都得记住在使用前上锁、用过后解锁。许多(许多!)年前,我遇到过一个在共享资源上应用基于客户代码锁定的系统。代码中有几百处用到这个资源的地方。有位可怜的程序员忘记在其中一处做资源锁定。
该系统是个多终端分时系统,为Local 705 卡车司机联盟运行会计软件。计算机放在距Local 705总部50英里(约84.65km)以北的一间镶有高于地面的地板、环境可控的机房中。总部有几十位数据录入员,往终端输入记录。终端使用电话专线和600bit/s的半双工调制解调器连接到计算机。(这可是很久很久以前的事了。)
每天大概都会有一台终端毫无理由地“死锁”。死锁也不限定在某些终端或特定时间。就像是有人掷骰子选择死锁的时机和终端一般。有时,会有几台终端死锁。有时,好几天都不出现死锁情况。
刚开始,唯一的解决手段就是重启。但协同起来很不便。我们得打电话给总部,让大家都完成在终端上的工作。然后我们才能关机、重启。如果有人在做要花上一两个小时才能做完的事,被锁定的终端就只能一直等着。
经过几个星期的调试,我们发现,原因在于一个指针不同步的环形缓冲区计数器。该缓冲区控制向终端的输出。指针值说明缓冲区是空的,但计数器却指出缓冲区是满的。因为缓冲区是空的,就没什么可显示;但因为缓冲区也是满的,也就无法向其中加入可在屏幕上显示的内容。
我们知道了终端为何会死锁,但却不知道为什么环形缓冲区会不同步。我们用了点手段发现问题所在。当时程序能够读取计算机的前面板开关状态(这可是很久很久以前的事了)。我们写了个陷阱程序,侦测这些开关何时被拨动,然后查找既空又满的环形缓冲区。如果找到,就重置该缓冲区为空。乌拉!锁定的终端又重新开始显示了。
这样,在终端锁定时就不必重启系统了。客户只需要打电话告诉我们出现死锁,我们就径直走到机房,拨动一下开关即可。
当然,有时他们会在周末加班,但是我们可不加班。所以我们又在计划列表中添加了一个函数,每分钟检查一次全部环形缓冲区,重置既空又满的缓冲区。在客户打电话之前,显示就已经恢复正常了。
在发现问题原因之前,我们花了好几个星期查看一页又一页的单片机汇编语言代码。我们已经完成计算,算出死锁的频率是周期性的,而且其中有一处未受保护的环形缓冲区使用。所以,剩下的任务就是找出那个错误的用法。不幸这是多年以前的事,那时既没有搜索工具,也没有交叉引用或任何其他自动化帮助手段。我们只能细查代码清单。
在芝加哥1971年的寒冬,我学到了重要的一课。基于客户代码的锁定实在不可靠。
A.4.3 基于服务端的锁定
按照以下方式修改IntegerIterator也能消除重复:
public class IntegerIteratorServerLocked {
    private Integer nextValue = 0;
    public synchronized Integer getNextOrNull() {
        if (nextValue < 100000)
            return nextValue++;
        else
            return null;
    }
}
客户代码也要修改:
while (true) {
    Integer nextValue = iterator.getNextOrNull();
    if (next == null)
        break;
    // do something with nextValue
}
在这种情形下,我们实际上是修改了类的API,使其能适应多线程3。客户端需要做null检查,而不是检查hasNext( )。
通常你应该选用基于服务端的锁定,因为:
它减少了重复代码——采用基于客户代码的锁定,每个客户端都要正确锁定服务端。把锁定代码放到服务端,客户端就能自由使用对象,不必费心编写额外的锁定代码;
它提升了性能——在单线程部署中,可以用非多线程安全服务端代码替代线程安全客户端,从而省去花销;
它减少了出错的可能性——只会有一个程序员忘记上锁;
它执行了单一策略——该策略只在服务端这一处地方实施,而不是在许多地方(每个客户端)实施;
它缩减了共享变量的作用范围——客户端不必关心它们或它们是如何锁定的。一切都隐藏在服务端。如果出错,要侦查的范围就小多了。
如果你无法修改服务端代码又该如何?
使用ADAPTER模式修改API,添加锁定;
public class ThreadSafeIntegerIterator {
    private IntegerIterator iterator = new IntegerIterator();
    public synchronized Integer getNextOrNull() {
        if(iterator.hasNext())
            return iterator.next();
        return null;
    }
}
更好的方法是使用线程安全的群集和扩展接口。
A.5 提升吞吐量
假设我们打算连接上网,从一个URL列表中读取一组页面的内容。读到一个页面时,解析该页面并得到一些统计结果。读完所有页面后,打印出一份提要报表。
下面的类返回给定URL的页面内容:
public class PageReader {
    //...
    public String getPageFor(String url) {
        HttpMethod method = new GetMethod(url);
        try {
            httpClient.executeMethod(method);
            String response = method.getResponseBodyAsString();
            return response;
        } catch (Exception e) {
            handle(e);
        } finally {
            method.releaseConnection();
        }
    }
}
下一个类是给出URL迭代器中每个页面的内容的迭代器:
public class PageIterator {
    private PageReader reader;
    private URLIterator urls;
    public PageIterator(PageReader reader, URLIterator urls) {
        this.urls = urls;
        this.reader = reader;
    }
    public synchronized String getNextPageOrNull() {
        if (urls.hasNext())
            getPageFor(urls.next());
        else
            return null;
    }
    public String getPageFor(String url) {
        return reader.getPageFor(url);
    }
}
PageIterator的一个实体可为多个不同线程共享,每个线程使用自己的PageReader实体读取并解析从迭代器中得到的页面。
注意,我们把synchronized代码块的数量限制在小范围之内。它只包括深处于PageIterator内部的临界区。最好是尽可能少地使用同步。
A.5.1 单线程条件下的吞吐量
来做个简单计算。鉴于讨论的目的,假定:
获取一个页面的I/O时间(平均)是1s;
解析一个页面的处理时间(平均)是0.5s;
I/O操作不耗费处理器能力,而解析页面耗费100%处理器能力。
对于单个线程要处理的N个页面,总的执行时间为1.5s*N。图A-1显示了13个页面或大概19.5s的快照。
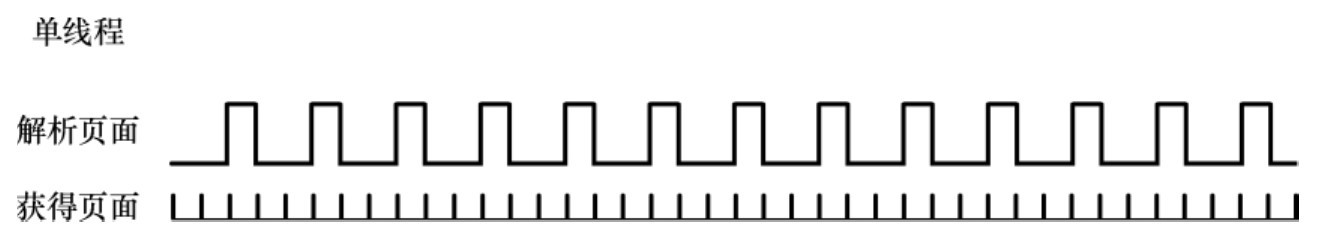
图A-1 单线程
A.5.2 多线程条件下的吞吐量
如果能够以任意次序获得页面并独立处理页面,就有可能利用多线程提升吞吐量。如果我们使用三个线程会如何?在同一时间内能获取多少个页面呢?
如你在图A-2中所见,多线程方案中与处理器能力有关的页面解析操作可以和与I/O有关的页面读取操作叠加进行。在理想状态下,这意味着处理器力尽其用。每个耗时一秒钟的页面读取操作都与两次解析操作叠加进行。这样,我们就能在每秒钟内处理两个页面,即三倍于单线程方案的吞吐量。
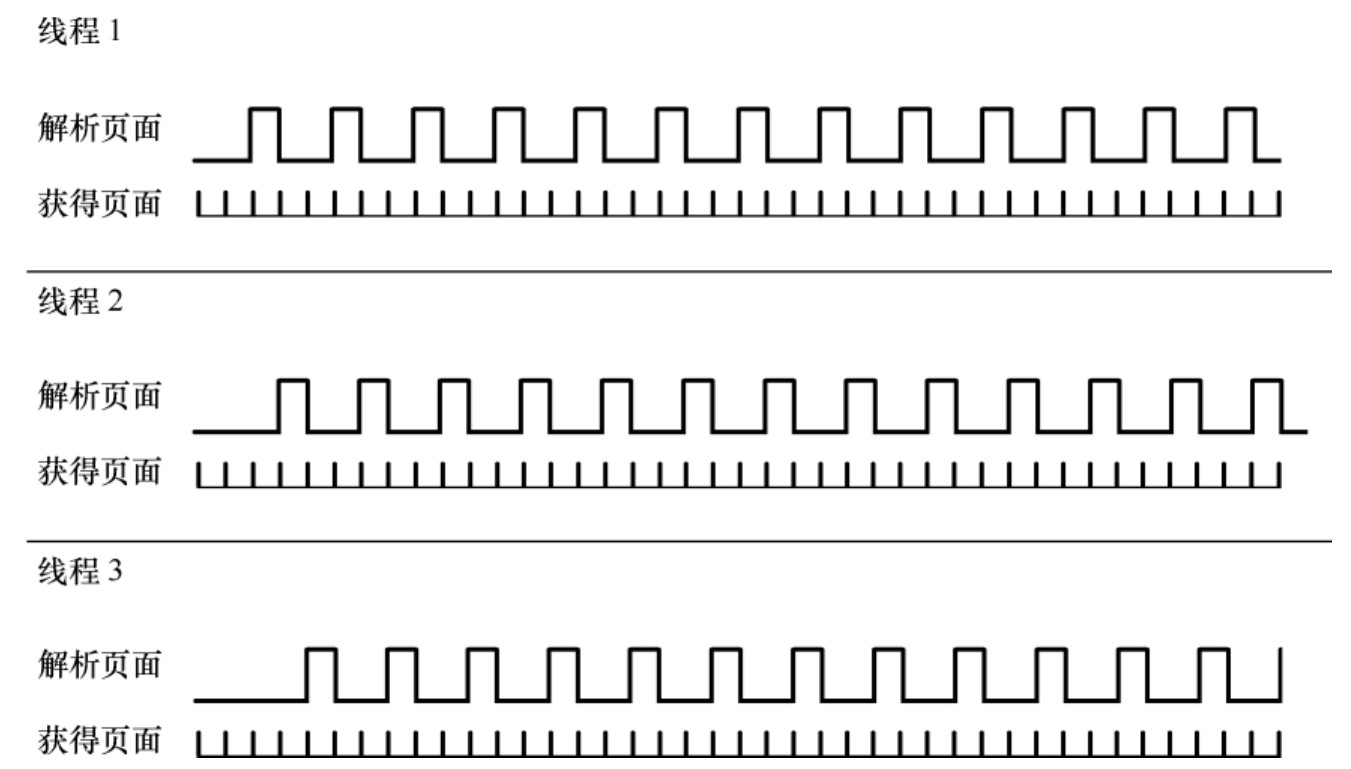
图A-2 三个并发线程
A.6 死锁
想象一个拥有两个有限共享资源池的Web应用程序。
一个用于本地临时工作存储的数据库连接池;
一个用于连接到主存储库的MQ池。
假定该应用中有两个操作:创建和更新。
创建——获取到主存储库和数据库的连接。与主存储库协调,并把工作保存到本地临时工作数据库;
更新——先获取到数据库的连接,再获取到主存储库的连接。从临时工作数据库中读取数据,再发送给主存储库。
如果用户数量多于池的大小会怎样?假设每个池中能容纳10个资源。
有10个用户尝试创建,获取了10个数据库连接,每个线程在获取到数据库连接之后、获取到主存储库连接之前都被打断;
有10个用户尝试更新,获取了10个主存储库连接,每个线程在获取到主存储库连接之后、获取到数据库连接之前都会被打断;
现在那10个“创建”线程必须等待获取主存储库连接,但那10个“更新”线程必须等待获取数据库连接;
死锁。系统永远无法恢复。
这听起来不太会出现,但谁会想要一个每隔一周就僵在那里不动的系统呢?谁想要调试出现了难以复现的症状的系统呢?这种问题突然发生,然后得花上好几个星期才能解决。
典型的“解决方案”是加入调试语句,发现问题。当然,调试语句对代码的修改足以令死锁在不同情况下发生,而且要几个月后才会再出现4。
要真正地解决死锁问题,我们需要理解死锁的原因。死锁的发生需要4个条件:
互斥;
上锁及等待;
无抢先机制;
循环等待。
A.6.1 互斥
当多个线程需要使用同一资源,且这些资源满足下列条件时,互斥就会发生。
无法在同一时间为多个线程所用;
数量上有限制。
这种资源的常见例子是数据库连接、打开后用于写入的文件、记录锁或是信号量。
A.6.2 上锁及等待
当某个线程获取一个资源,在获取到其他全部所需资源并完成其工作之前,不会释放这个资源。
A.6.3 无抢先机制
线程无法从其他线程处夺取资源。一个线程持有资源时,其他线程获得这个资源的唯一手段就是等待该线程释放资源。
A.6.4 循环等待
这也被称为“死命拥抱”。想象两个线程,T1和T2,还有两个资源,R1和R2。T1拥有R1,T2拥有R2。T1需要R2,T2需要R1。如此就出现了如图A-3所示的情形。
这4种条件都是死锁所必需的。只要其中一个不满足,死锁就不会发生。
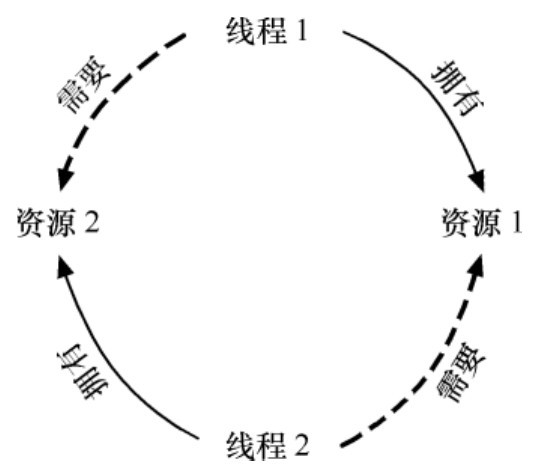
图A-3 循环等待
A.6.5 不互斥
避免死锁的一种策略是规避互斥条件。你可以:
使用允许同时使用的资源,如AtomicInteger;
增加资源数量,使其等于或大于竞争线程的数量;
在获取资源之前,检查是否可用。
不幸的是,多数资源都有上限,且不能同时使用。而且第二个资源的标识也常常要依据对第一个资源的操作结果来判断。不过别丧气,还有3个其他条件呢。
A.6.6 不上锁及等待
如果拒绝等待,就能消除死锁。在获得资源之前检查资源,如果遇到某个繁忙资源,就释放所有资源,重新来过。
这种手段带来几个潜在问题:
线程饥饿——某个线程一直无法获得它所需的资源(它可能需要某种很少能同时获得的资源组合);
活锁——几个线程可能会前后相连地要求获得某个资源,然后再释放一个资源,如此循环。这在单纯的CPU任务排列算法中尤其有可能出现(想想嵌入式设备或单纯的手写线程平衡算法)。
二者都能导致较差的吞吐量。第一个的结果是CPU利用率低,第二个的结果是较高但无用的CPU利用率。
尽管这种策略听起来没效率,但也好过没有。至少,如果其他方案不奏效,这种手段几乎总可以用上。
A.6.7 满足抢先机制
避免死锁的另一策略是允许线程从其他线程上夺取资源。这通常利用一种简单的请求机制来实现。当线程发现资源繁忙,就要求其拥有者释放之。如果拥有者还在等待其他资源,就释放全部资源并重新来过。
这和上一种手段相似,但好处是允许线程等待资源。这减少了线程重新启动的次数。不过,管理所有请求可要花点心思。
A.6.8 不做循环等待
这是避免死锁的最常用手段。对于多数系统,它只要求一个为各方认同的约定。
在上面的例子中线程1同时需要资源1和资源2、线程2同时需要资源2和资源1,只要强制线程1和线程2以同样次序分配资源,循环等待就不会发生。
更普遍地,如果所有线程都认同一种资源获取次序,并按照这种次序获取资源,死锁就不会发生。就像其他策略一样,这也会有问题:
获取资源的次序可能与使用资源的次序不匹配;一开始获取的资源可能在最后才会用到。这可能导致资源不必要地被长时间锁定;
有时无法强求资源获取顺序。如果第二个资源的ID来自对第一个资源操作的结果,获取次序也无从谈起。
有许多避免死锁的方法。有些会导致饥饿,另外一些会导致对CPU能力的大量耗费和降低响应率。TANSTAAFL5!
将解决方案中与线程相关的部分分隔出来,再加以调整和试验,是获得判断最佳策略所需的洞见的正道。
A.7 测试多线程代码
怎么才能编写显示以下代码有错的测试呢?
01:  public class ClassWithThreadingProblem  {
02:     int nextId;
03:
04:     public int  takeNextId() {
05:       return nextId++;
06:     }
07:  }
下面是对能证明上列代码有错的测试的描述:
记住nextId的当前值;
创建两个线程,每个都调用takeNextId( )一次;
验证nextId比开始时大2;
持续运行,直至发现nextId只比开始时大1为止。
代码清单A-2展示了这样一个测试:
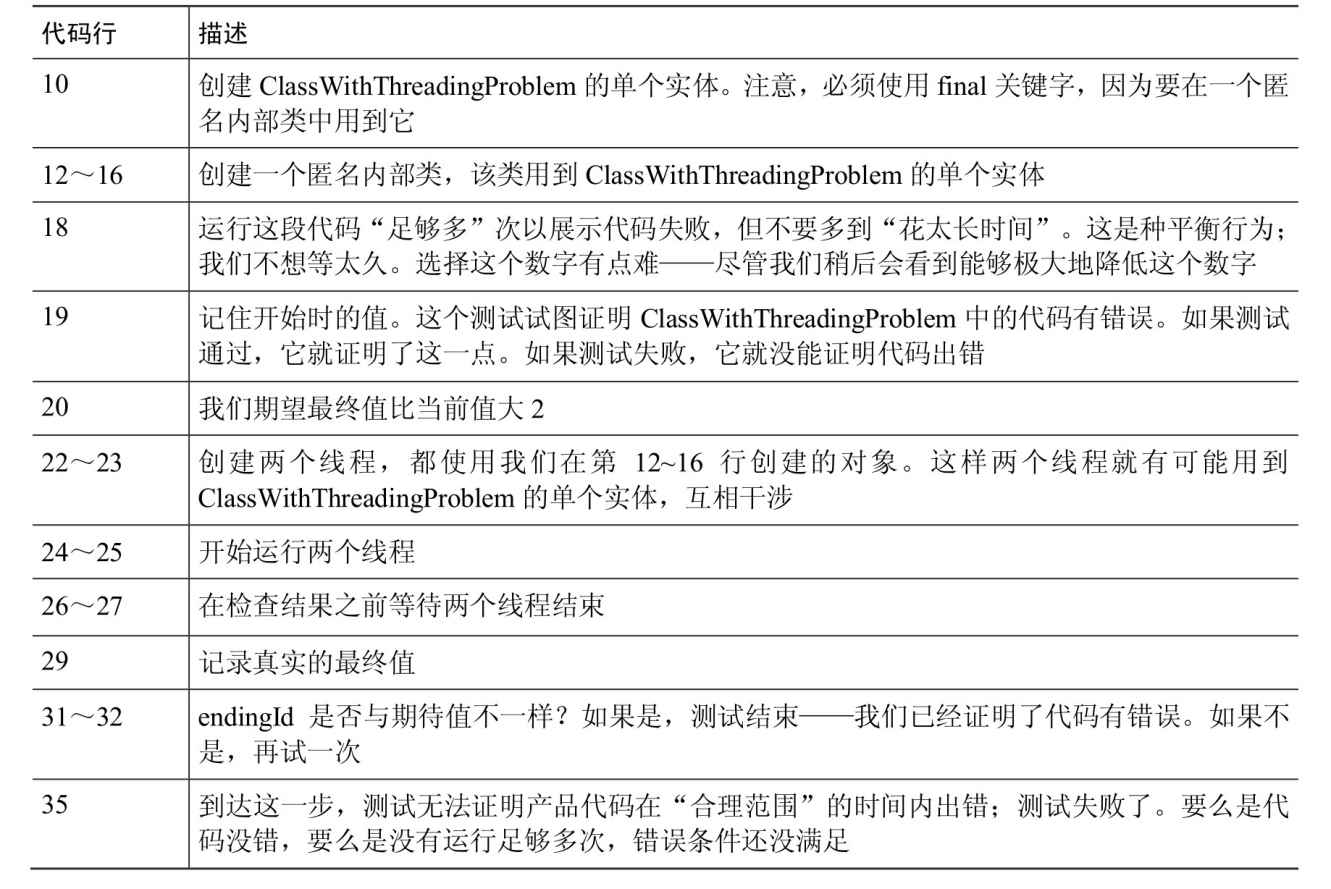
代码清单A-2 ClassWithThreadingProblemTest.java
01: package example;
02:
03: import static org.junit.Assert.fail;
04:
05: import org.junit.Test;
06:
07: public class ClassWithThreadingProblemTest {
08: @Test
09: public void twoThreadsShouldFailEventually() throws Exception {
10: final ClassWithThreadingProblem classWithThreadingProblem
= new ClassWithThreadingProblem();
11:
12:       Runnable runnable =  new Runnable()  {
13:          public void  run()  {
14:            classWithThreadingProblem.takeNextId();
15:          }
16:       };
17:
18:       for (int i = 0;  i < 50000; ++i)  {
19:          int startingId = classWithThreadingProblem.lastId;
20:          int expectedResult =  2 + startingId;
21:
22: Thread t1 = new Thread(runnable);
23: Thread t2 = new Thread(runnable);
24: t1.start();
25: t2.start();
26: t1.join();
27: t2.join();
28:
29: int endingId = classWithThreadingProblem.lastId;
30:
31: if (endingId != expectedResult)
32: return;
33: }
34:
35: fail("Should have exposed a threading issue but it did not.");
36: }
37: }
表A-3 代码清单A-2的注解
这个测试当然设置了满足并发更新问题发生的条件。不过,问题发生得如此频繁,测试也就极有可能侦测不到。
实际上,要真正侦测到问题,需要将循环数量设置到100万次以上。即便是这样,在10个100万次循环的执行中,错误也只发生了一次。这意味着我们可能要把循环次数设置为超过亿次才能获得可靠的失败证明。要等多久呢?
即便我们调优测试,在单台机器上得到可靠的失败证明,我们可能还需要用不同的值来重新设置测试,得到在其他机器、操作系统或不同版本的JVM上的失败证明。
而且这只是个简单问题。如果连这个简单问题都无法轻易获得出错证明,我们怎么能真正侦测复杂问题呢?
我们能用什么手段来证明这个简单错误呢?而且,更重要的是,我们如何能写出证明更复杂代码中的错误的测试呢?我们怎样才能在不知道从何处着手时知道代码是否出错了呢?下面是一些想法:
蒙特卡洛测试。测试要灵活,便于调整。多次运行测试——在一台测试服务器上——随机改变调整值。如果测试失败,代码就有错。确保及早编写这些测试,好让持续集成服务器尽快开始运行测试。另外,确认小心记录了在何种条件下测试失败。
在每种目标部署平台上运行测试。重复运行。持续运行。测试在不失败的前提下运行得越久,就越能说明:
- 生产代码正确;
或;
- 测试不足以暴露问题。
在另一台有不同负载的机器上运行测试。能模拟生产环境的负载,就模拟之。
即便你做了所有这些,还是不见得有很好的机会发现代码中的线程问题。最阴险的问题拥有很小的截面,在十亿次执行中只会发生一次。这类错误是复杂系统的噩梦。
A.8 测试线程代码的工具支持
IBM提供了一个名为ConTest的工具6。它能对类进行装置,令非线程安全代码更有可能失败。
我们与IBM或开发ConTest的团队没有直接关系。有位同事发现了这个工具。在用了几分钟后,我们发现自己发现线程问题的能力得到了很大提升。
下面是使用ConTest的简要步骤:
编写测试和生产代码,确保有专门模拟多用户在多种负载情况下操作的测试,如上文所述;
用ConTest装置测试和生产代码;
运行测试。
用ConTest装置代码后,原本千万次循环才能暴露一个错误的比率提升到30次循环就能找到错误。以下是装置代码后的几次测试运行结果值:13、23、0、54、16、14、6、69、107、49和2。显然装置后的类更加容易和可靠地被证明失败。
A.9 小结
本章只是在并发编程广阔而可怕的领地上的短暂逗留罢了。我们只触及了地表。我们在这里强调的,只是保持并发代码整洁的一些规程,如果要编写并发系统,还有许多东西要学。建议从Doug Lea的大作Concurrent Programming in Java:Design Principles and Patterns开始7。
在本章中,我们谈到并发更新,还有清理及避免同步的规程。我们谈到线程如何提升与I/O 有关的系统的吞吐量,展示了获得这种提升的整洁技术。我们谈到死锁及干净地避免死锁的规程。最后,我们谈到通过装置代码暴露并发问题的策略。
A.10 教程:完整代码范例
A.10.1 客户端/服务器非线程代码
代码清单A-3 Server.java
package com.objectmentor.clientserver.nonthreaded;
import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;
import java.net.SocketException;
import common.MessageUtils;
public class Server implements Runnable {
    ServerSocket serverSocket;
    volatile boolean keepProcessing = true;
    public Server(int port, int millisecondsTimeout) throws IOException {
        serverSocket = new ServerSocket(port);
        serverSocket.setSoTimeout(millisecondsTimeout);
    }
    public void run() {
        System.out.printf("Server Starting\n");
        while (keepProcessing) {
            try {
                System.out.printf("accepting client\n");
                Socket socket = serverSocket.accept();
                System.out.printf("got client\n");
                process(socket);
            } catch (Exception e) {
                handle(e);
            }
        }
    }
    private void handle(Exception e) {
        if (!(e instanceof SocketException)) {
            e.printStackTrace();
        }
    }
    public void stopProcessing() {
        keepProcessing = false;
        closeIgnoringException(serverSocket);
    }
    void process(Socket socket) {
        if (socket == null)
            return;
        try {
            System.out.printf("Server: getting message\n");
            String message = MessageUtils.getMessage(socket);
            System.out.printf("Server: got message: %s\n", message);
            Thread.sleep(1000);
            System.out.printf("Server: sending reply: %s\n", message);
            MessageUtils.sendMessage(socket, "Processed: " + message);
            System.out.printf("Server: sent\n");
            closeIgnoringException(socket);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
    private void closeIgnoringException(Socket socket) {
        if (socket != null)
            try {
                socket.close();
            } catch (IOException ignore) {
            }
    }
    private void closeIgnoringException(ServerSocket serverSocket) {
        if (serverSocket != null)
            try {
                serverSocket.close();
            } catch (IOException ignore) {
            }
    }
}
代码清单A-4 ClientTest.java
package com.objectmentor.clientserver.nonthreaded;
import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;
import java.net.SocketException;
import common.MessageUtils;
public class Server implements Runnable {
    ServerSocket serverSocket;
    volatile boolean keepProcessing = true;
    public Server(int port, int millisecondsTimeout) throws IOException {
        serverSocket = new ServerSocket(port);
    serverSocket.setSoTimeout(millisecondsTimeout);
}
public void run() {
    System.out.printf("Server Starting\n");
    while (keepProcessing) {
        try {
            System.out.printf("accepting client\n");
            Socket socket = serverSocket.accept();
            System.out.printf("got client\n");
            process(socket);
        } catch (Exception e) {
            handle(e);
        }
    }
}
private void handle(Exception e) {
    if (!(e instanceof SocketException)) {
        e.printStackTrace();
    }
}
public void stopProcessing() {
    keepProcessing = false;
    closeIgnoringException(serverSocket);
}
void process(Socket socket) {
    if (socket == null)
        return;
    try {
        System.out.printf("Server: getting message\n");
        String message = MessageUtils.getMessage(socket);
        System.out.printf("Server: got message: %s\n", message);
        Thread.sleep(1000);
        System.out.printf("Server: sending reply: %s\n", message);
        MessageUtils.sendMessage(socket, "Processed: " + message);
        System.out.printf("Server: sent\n");
        closeIgnoringException(socket);
    } catch (Exception e) {
        e.printStackTrace();
    }
}
private void closeIgnoringException(Socket socket) {
    if (socket != null)
        try {
            socket.close();
        } catch (IOException ignore) {
        }
}
    private void closeIgnoringException(ServerSocket serverSocket) {
        if (serverSocket != null)
            try {
                serverSocket.close();
            } catch (IOException ignore) {
            }
    }
}
代码清单A-5 MessageUtils.java
package common;
import java.io.IOException;
import java.io.InputStream;
import java.io.ObjectInputStream;
import java.io.ObjectOutputStream;
import java.io.OutputStream;
import java.net.Socket;
public class MessageUtils {
    public static void sendMessage(Socket socket, String message)
                    throws IOException {
    OutputStream stream = socket.getOutputStream();
    ObjectOutputStream oos = new ObjectOutputStream(stream);
    oos.writeUTF(message);
    oos.flush();
    }
    public static String getMessage(Socket socket) throws IOException {
        InputStream stream = socket.getInputStream();
        ObjectInputStream ois = new ObjectInputStream(stream);
        return ois.readUTF();
    }
}
A.10.2 使用线程的客户端/服务器代码
把服务器修改为使用多线程,只需要对处理消息进行修改即可(新的代码行用粗体标出):
void process(final Socket socket) {
    if (socket == null)
        return;
    Runnable clientHandler = new Runnable() {
        public void run() {
            try {
                System.out.printf("Server: getting message\n");
                String message = MessageUtils.getMessage(socket);
                System.out.printf("Server: got message: %s\n", message);
                Thread.sleep(1000);
                System.out.printf("Server: sending reply: %s\n", message);
                MessageUtils.sendMessage(socket, "Processed: " + message);
                System.out.printf("Server: sent\n");
                closeIgnoringException(socket);
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
    };
    Thread clientConnection = new Thread(clientHandler);
    clientConnection.start();
}
Footnotes
-
原注:你可以自行验证修改之前和之后的代码。复查前文的非多线程代码。复查之后的多线程代码。 ↩
-
原注:这说得有点简单了。鉴于讨论的目的,我们就用这个简化模型好了。 ↩
-
原注:实际上,Iterator接口天生不是线程安全的。它并不为多线程而设计,所以出现这种情况也不奇怪。 ↩
-
原注:例如,有人添加了一些调试输出,问题“不见了”。调试代码“修正”了问题,其实问题还在系统中存在。 ↩
-
原注:世上没有免费的午餐(There ain’t no such thing as a free lunch)。 ↩
-
原注:http://www.haifa.ibm.com/projects/verification/contest/index.html。 ↩
-
原注:见[Lea99]p.191。 ↩